


 您已经拒绝加入团体

 2026-10-30
 7
 0
【摘要】 说明河水天然有机质背景、空白样设计、模型验证与颗粒法确认的边界。
河水微塑料DOM机器学习验证的关键,是把天然有机质背景视为模型设计的一部分。受控浸出体系中能够区分的信号,进入河水后可能被背景DOM覆盖或改变。研究不应直接把实验室模型套用到天然水体,而要设置同日、同地点或可比条件下的空白河水,并明确背景校正、训练验证划分和结果解释边界。科学指南针可围绕河水微塑料DOM筛查研究沟通环境检测与验证方案。
河水验证先处理背景
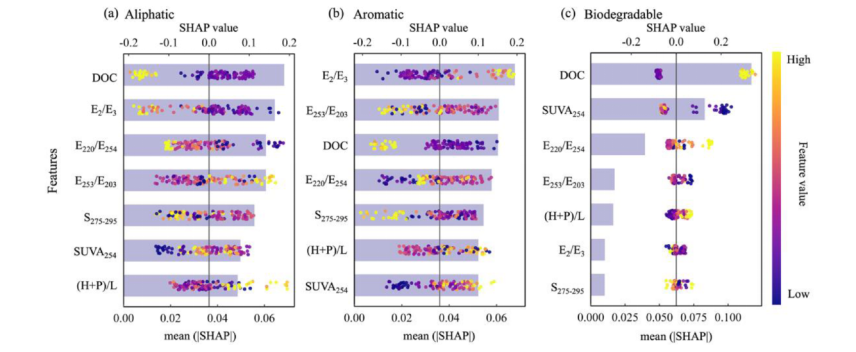
河水中的天然有机质会影响DOC、吸收和荧光指标。图表展示的是经背景处理后的模型验证结果,说明背景校正是验证流程的一步,而不是发布模型分数后的附加说明。空白样、加标或对应浸出样之间的关系,需要在项目开始时确定;否则模型给出的类别倾向难以判断来自微塑料释放信号还是河水本身的DOM变化。
验证项目的样本表怎么设计
|
项目字段 |
建议记录内容 |
目的 |
|---|---|---|
|
河水背景 |
空白样时间、地点、保存状态 |
说明背景DOM来自哪里 |
|
处理样本 |
聚合物分组、浸出时间、样本编号 |
保留训练或验证样本对应关系 |
|
光谱字段 |
DOC、吸收和荧光指标及处理规则 |
保证输入变量可追溯 |
|
模型结果 |
类别结果、混淆情况、特征贡献 |
解释模型在哪些类别存在边界 |
同一研究中,天然河水与超纯水结果不能默认直接对照。前者含有背景有机质、颗粒和其他影响因素,后者更适合观察受控浸出信号。若要比较两种体系,应分别保留样本编号、前处理记录和背景处理步骤,让读者知道哪些比较具有共同前提。
模型验证不只看一个分数
验证阶段需要同时看类别之间的误分、不同类别的召回表现以及输入特征的贡献。某个综合指标仍较高,并不代表所有类别都能同样稳定地区分;天然背景通常更容易削弱相近类别之间的边界。将混淆情况和特征贡献与结果一起保存,能避免把“模型仍可筛查”误写成“已完成真实河流颗粒鉴定”。
何时需要回到颗粒级方法
当研究需要确认单个颗粒的聚合物类型、粒径或形貌时,仍需在方案中安排拉曼、FTIR等颗粒级方法。DOM和机器学习结果可以帮助筛查和解释样本,但它们不能取代颗粒法所提供的直接信息。对于不同流域、材料配方、老化状态或采样季节,均应以新的验证设计判断模型是否适用。
想先搭建浸出和指纹字段,可阅读MP-DOM指纹筛查方案如何设计。如需讨论河水背景下的MP-DOM机器学习验证,可向科学指南针提供河水背景、空白样设计、目标聚合物分组和计划输出字段,沟通环境检测方案。
空白样与处理样怎样形成可比对照
河水验证的空白样不只是一个“没有加入微塑料”的对照。它应尽量与处理样处在可比的采样时间、地点、保存条件和检测批次中,使其能够反映当时的天然有机质背景。若研究使用多个河段、季节或水文条件,也应分别保留背景记录,不能用一个空白值代表全部水体。背景处理的规则、对数变换或归一化方式都要在模型输入表中明确记录。
对于加标、浸出或材料处理样,项目表应区分实际加入的聚合物分组、粒径和时间点,以及与哪个空白样对应。只有这种对应关系清晰,模型验证才能说明它识别的是额外的MP-DOM信号,而不是把自然背景的波动误判为某个类别。
出现误分时先复核什么
当脂肪族、芳香族或可降解类别之间出现误分时,先检查空白扣除、样本编号、光谱质量控制和训练验证划分,而不是立即调整结论。再查看哪些特征对类别倾向贡献更大,以及该类样本是否存在相近背景条件。必要时可增加独立时间点、不同背景河水或颗粒级验证,以确认模型边界。这样的复核路径能让模型结果服务于研究决策,而不会被误读为对实际河流中每个颗粒的直接鉴定。
验证报告还应说明哪些河水条件尚未覆盖。这样,即使模型在某一套背景下表现可用,也不会被外推为所有流域和季节的固定结论。
对未覆盖条件的标注,也是后续扩大样本与重新验证的起点。
当项目需要将结果用于比较不同河段时,还应记录水体颜色、浊度或其他会影响光学测量解释的现场信息。它们不必被强行纳入同一模型,但应作为结果复核时的背景记录,使后续研究能够判断模型偏差是否与水体条件相关。




 上传附件